背景
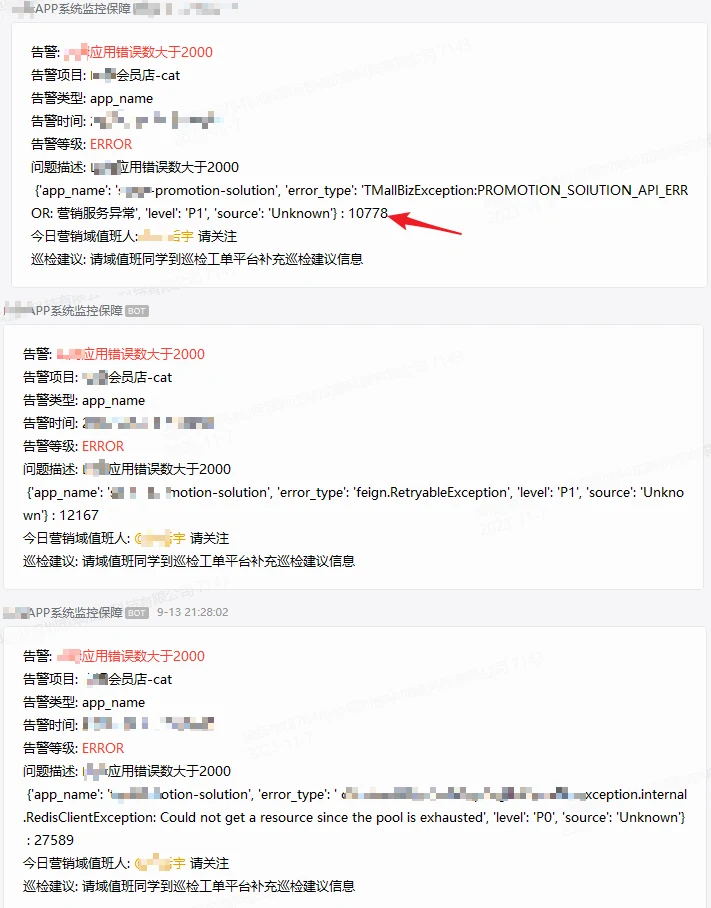
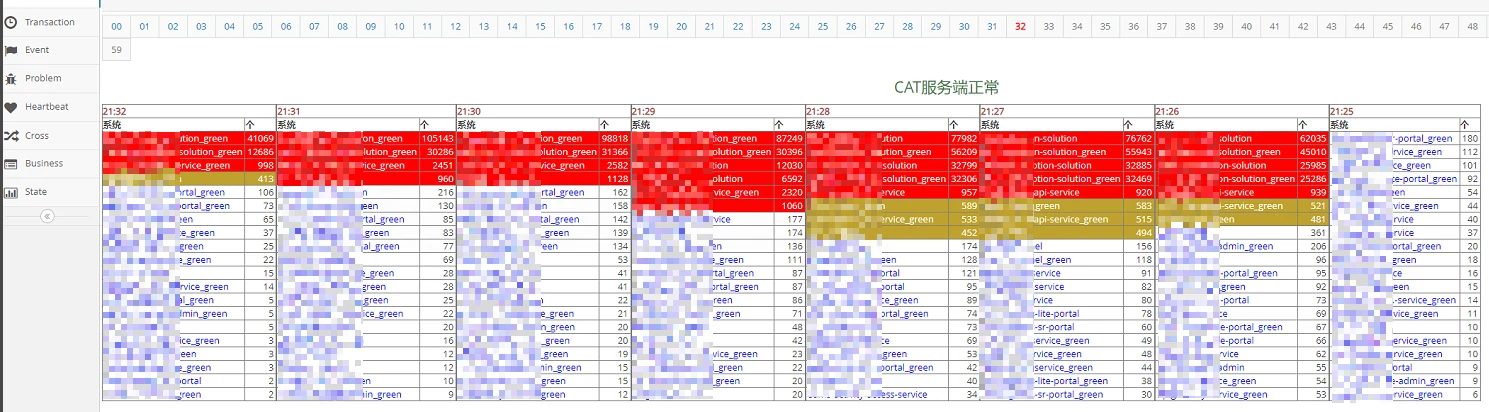
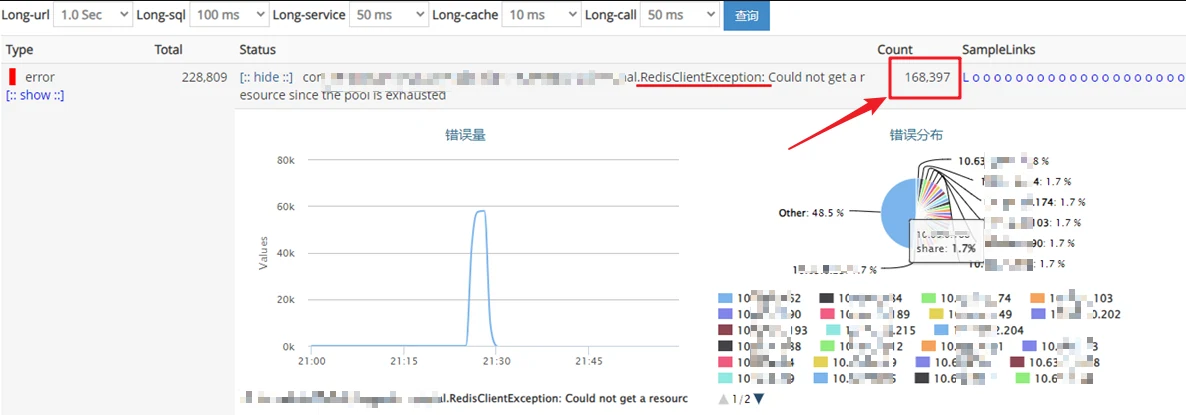
在一次现网迭代切流过程中,promotion-solution 门面服务收到大量告警(feign.RetryableException),promotion-solution 中台服务收到大量告警( RedisClientException: Could not get a resource since the pool is exhausted),企微群消息产生一连串的连锁告警,很明显是由于中台服务的Redis出现问题了,导致引起了其他服务的异常,起初以为是Redis抖动一下而已,没想到十几分钟内一直都出现异常,甚至出现了 ClientAbortException,那就意味着服务都可能 hang 住了。
企微监控告警群
CAT - 异常
排查经过
- 看到出问题的是Redis,运维从腾讯云的Redis监控平台看到,Redis流量出口率已经达到100%(8G/s),CPU打高,有突刺问题。
- 在Redis监控平台看到是由于mget命令引起的,并且mget的数量是好几百个,最多有400+,从业务代码层面排查,是由于最近上线了一种新活动类型,运营配置了几百个满足条件的活动,导致了数量的暴增。
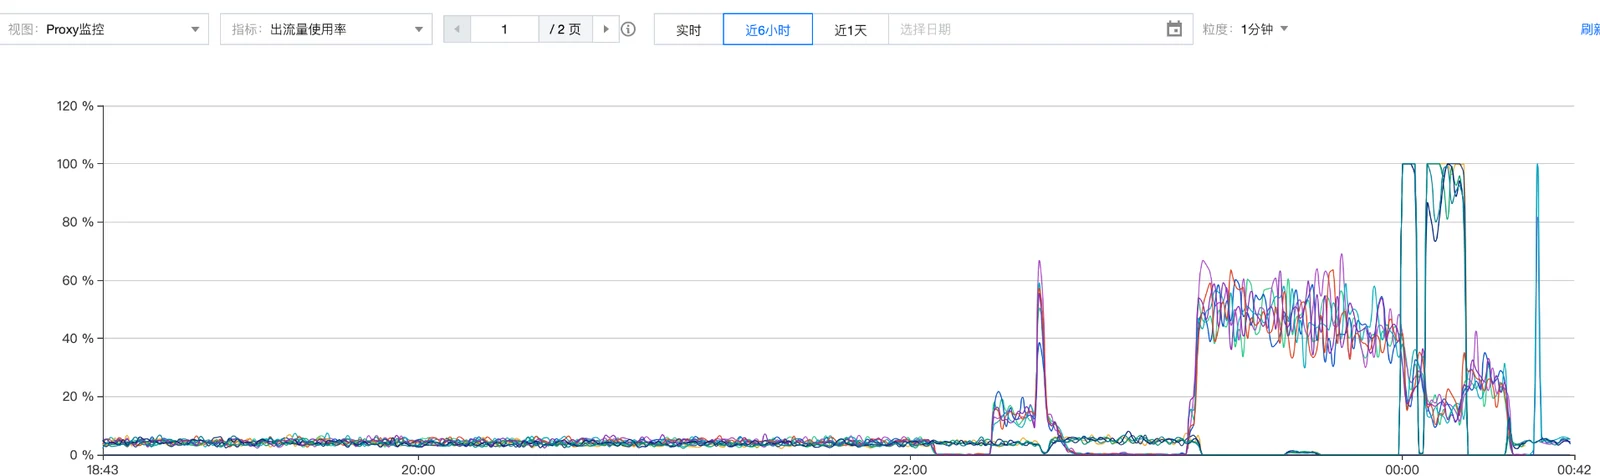
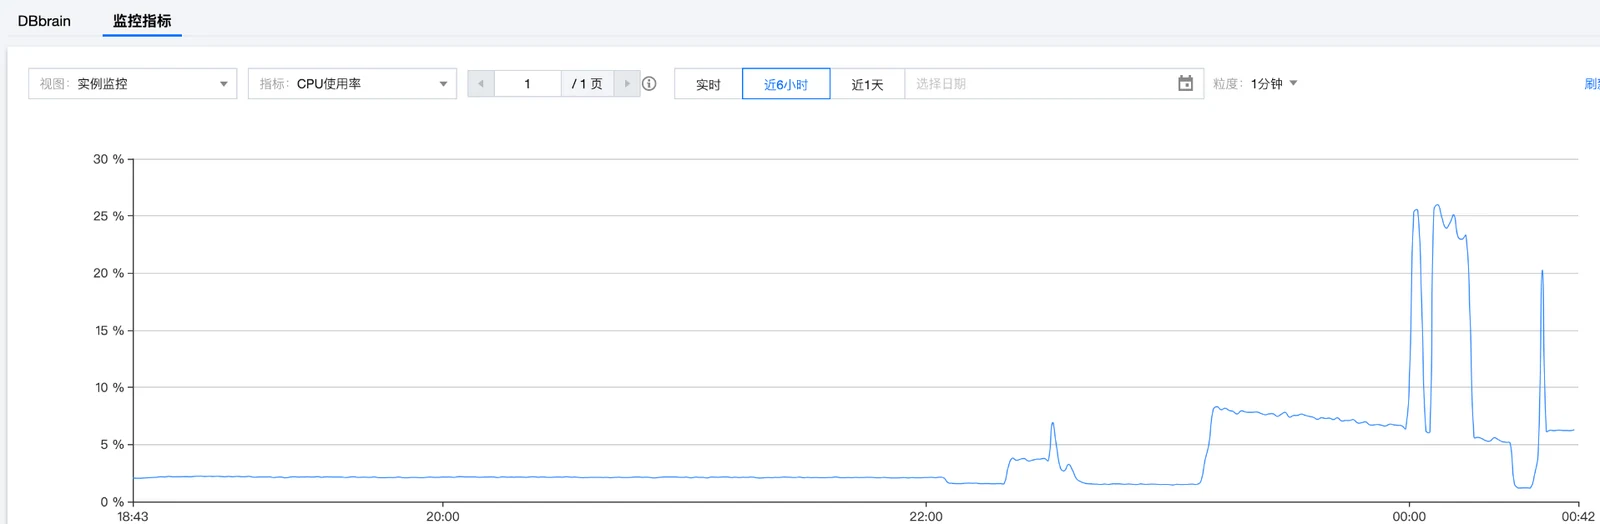
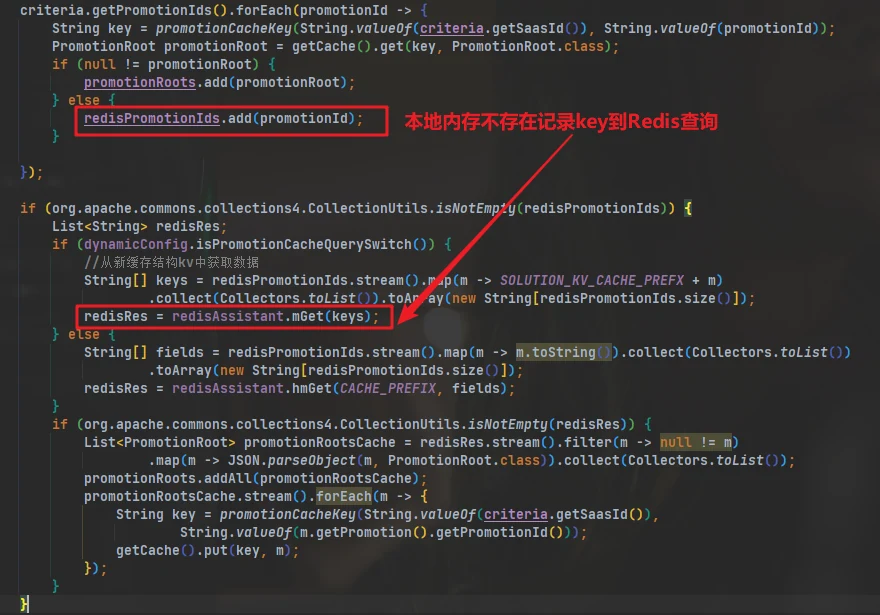
- 虽然活动数量是暴增,但是这几百个活动生效时间是下午2点左右,为什么是切流的时候才暴雷?这个和我们的代码写法有很大关系,也和集群模式有关联,首先代码层面是有一个本地缓存,由于切流过程中本地内存还没预热导致所有请求走到Redis(Redis击穿),并且这些缓存数据都是比较大的对象,因此很吃流量。还有一个问题就是服务的集群模式为金丝雀(蓝绿),流量来源不是均衡的,是根据城市划分的流量的,每个城市的流量命中活动不一样(比如上海的会员和深圳的会员看到的活动是不一样的,切流把上海命中的活动情况在之前深圳集群查询),在切流的过程中所有城市的流量都走到green,这个服务涉及了几个核心链路接口,总的服务QPS超过1w,引起了redis的穿透和击穿问题
紧急处理
- 运维对Redis进行了紧急升配(增加从节点数量,打开只读副本)
- 代码层面限制mget数量,降级防止打崩Redis
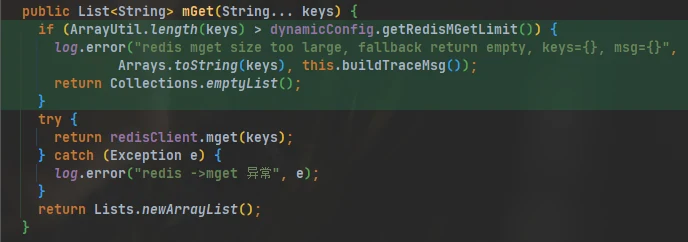
代码优化
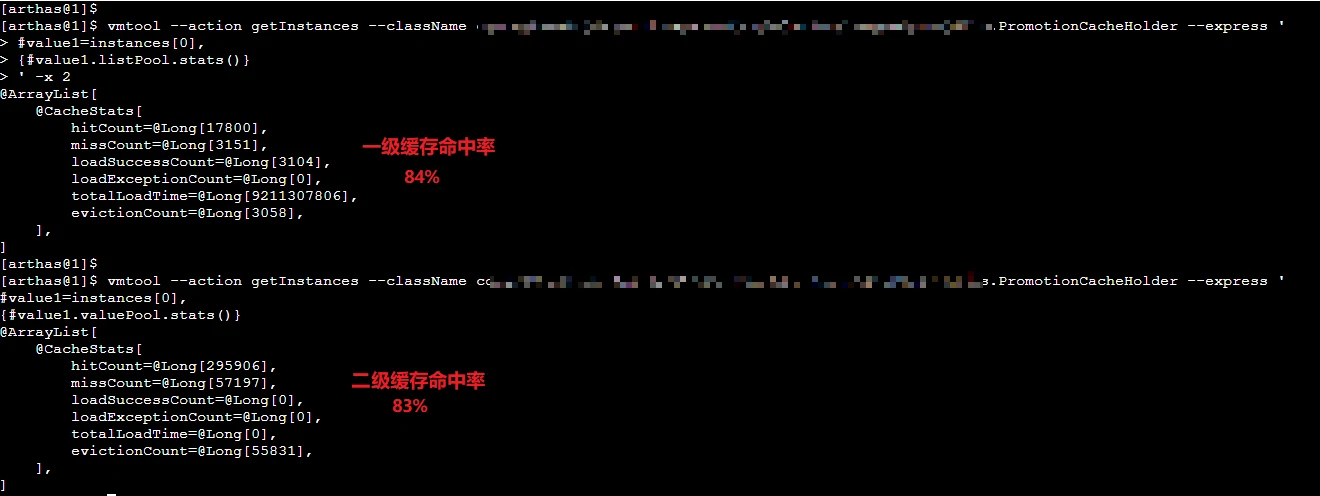
合并回源+ValueLoader机制:我们发现短时间内keys的请求是很雷同的,因此没什么是加一层不能解决的。所以在原有的本地缓存之上增加一层合并回源缓存,因此本地缓存会有二层缓存,一级是列表缓存用于合并回源,二级是活动信息缓存用于降低流量走到Redis,代码示例如下:
/**
 * 本地内存和Redis 缓存
 */
@Slf4j
@Component
public class PromotionCacheHolder {

    @Resource
    private PromotionRedisAssistant redisAssistant;
    @Resource
    private CacheManager cacheManager;
    private Cache promotionCache;

    @PostConstruct
    public void init() {
        promotionCache = cacheManager.getCache(Caches.promotion.name());
    }
    private final LoadingCache<String, String> keyPool = CacheBuilder.newBuilder()
            .recordStats()
            .concurrencyLevel(Runtime.getRuntime().availableProcessors())
            // 无须设置超时时间,只需控制容量即可
            .maximumSize(10000)
            .build(new CacheLoader<String, String>() {
                @Override
                public String load(String key) {
                    return key;
                }
            });

    private final com.google.common.cache.Cache<String, PromotionRoot> valuePool = CacheBuilder.newBuilder()
            .recordStats()
            .concurrencyLevel(Runtime.getRuntime().availableProcessors())
            // 本地缓存,可以适当放大时间和空间
            .softValues().maximumSize(1000).expireAfterWrite(10, TimeUnit.SECONDS)
            .build();

    private final LoadingCache<List<String>, List<PromotionRoot>> listPool = CacheBuilder.newBuilder()
            .recordStats()
            .concurrencyLevel(Runtime.getRuntime().availableProcessors())
            // 合并回源用,时间和空间无须太大
            .softValues().maximumSize(1000).expireAfterWrite(10, TimeUnit.SECONDS)
            .build(new CacheLoader<List<String>, List<PromotionRoot>>() {
                @Override
                public List<PromotionRoot> load(List<String> cacheKeys) {
                    return doGetPromotionList(cacheKeys);
                }
            });

    @SneakyThrows
    public List<PromotionRoot> getPromotionList(List<Long> promotionIds) {

        if (CollectionUtils.isEmpty(promotionIds)) return Collections.emptyList();

        List<String> cacheKeys = promotionIds.stream()
                .distinct().sorted().map(this::getCacheKey).collect(Collectors.toList());

        return listPool.get(cacheKeys);
    }

    private List<PromotionRoot> doGetPromotionList(List<String> cacheKeys){

        if (CollectionUtils.isEmpty(cacheKeys)) return Collections.emptyList();

        // 获取本地已存在的
        Map<String, PromotionRoot> existed = cacheKeys.stream()
                .collect(Collectors.toMap(Function.identity(), key ->  Optional.ofNullable(valuePool.getIfPresent(key))))
                .entrySet().stream().filter(e -> e.getValue().isPresent())
                .collect(Collectors.toMap(Map.Entry::getKey, e -> e.getValue().get()));

        String[] missedKey = cacheKeys.stream().filter(e -> !existed.containsKey(e)).toArray(String[]::new);

        if (missedKey.length == 0) return existed.values().stream().collect(Collectors.toList());

        // 查询本地不存在的
        Map<String, PromotionRoot> missed = Optional.ofNullable(redisAssistant.mGet(missedKey)).orElse(Collections.emptyList())
                .stream().filter(Objects::nonNull)
                .map(e -> JSON.parseObject(e, PromotionRoot.class))
                .collect(Collectors.toMap(e -> getCacheKey(e.getPromotionId().getPromotionId()), Function.identity()));

        // 更新本地不存在的
        missed.forEach(valuePool::put);

        // 合并已存在和刚获取的
        return Stream.concat(existed.values().stream(), missed.values().stream()).collect(Collectors.toList());
    }

    @SneakyThrows
    private String getCacheKey(Long promotionId) {
        return keyPool.get(SOLUTION_KV_CACHE_PREFX + promotionId);
    }

}
这是上线之后的命中率
GC异常
- 一波几折,以为这次加入了一层列表缓存上线之后就可以解决问题,结果我们准备上线时发现如果把流量完全放在一个集群上扛的时候,发现服务会被GC异常,导致服务重启。(这里缺少图,因为当时紧急回滚没有保留现场)
- 出现GC异常之后,运维看了下堆内存设置
-Xms7196m -Xmx7196m -Xmn5644m,发现堆内存设置7.2G,年轻代设置5.6G,运维还解释说年轻代设置那么大是之前出现过问题,所以设置年轻代比较大,但是原因忘记了。。。所以到这里我们可以知道老年代也就1.5G左右,然后由于JVM参数还设置了-XX:CMSInitiatingOccupancyFraction=75,意味着1.5G * 75% = 1G 左右就触发FullGC了,因此出现了GC异常导致服务hang触发pod重启。 - 那么现在的问题就是优化GC问题,但是我们这里也不敢贸然减少年轻代,只能从增大堆内存,
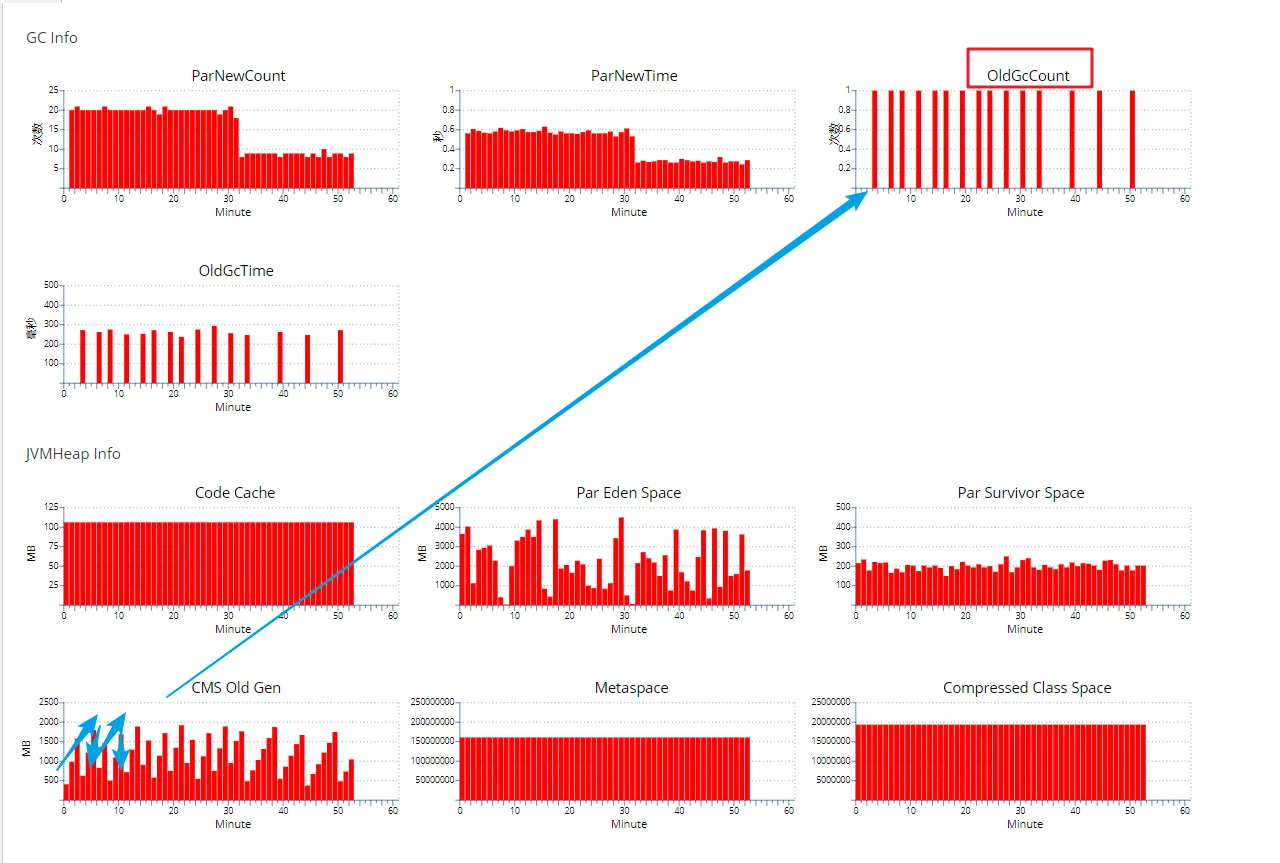
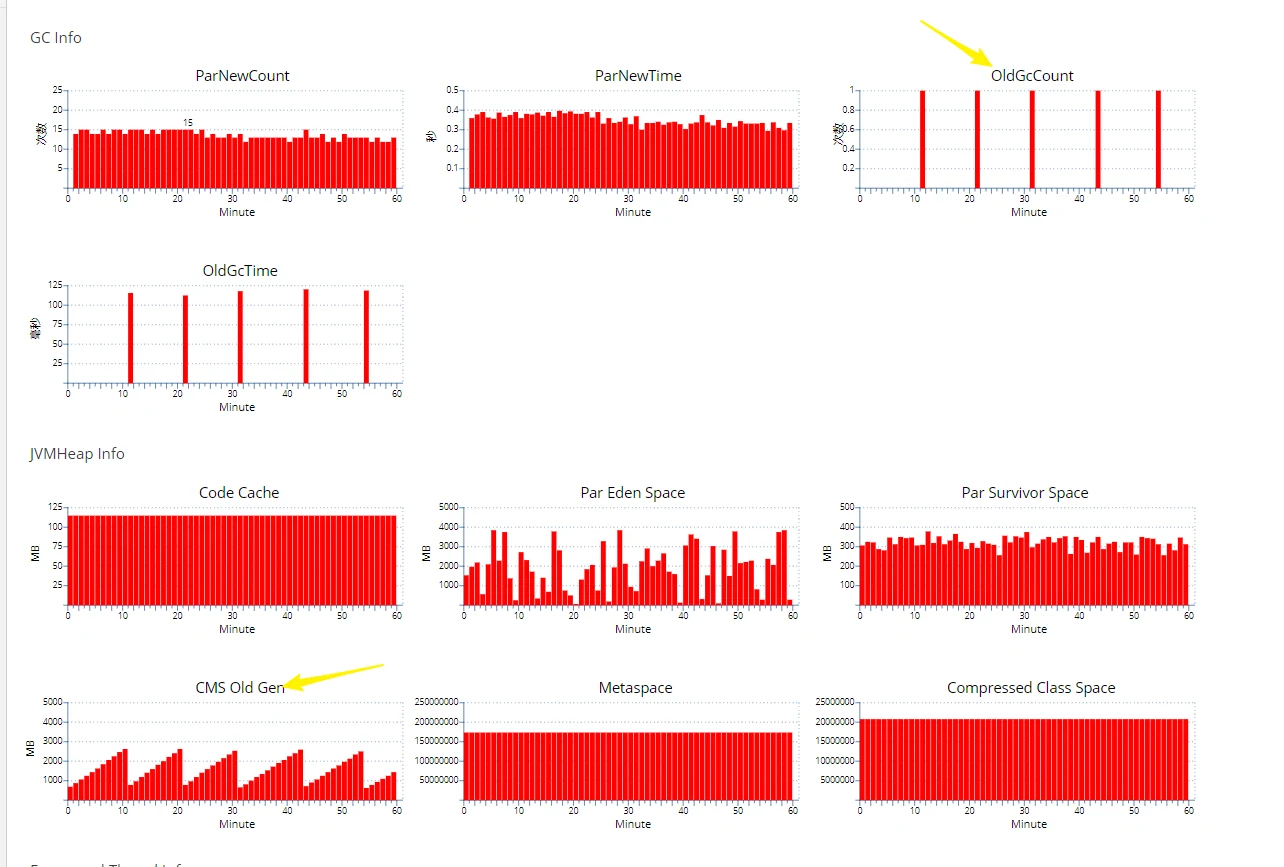
-Xms8196m -Xmx12000m -Xmn5644m,重新上线之后,GC没有异常了。但是我们发现FullGC是很频繁的(一小时大概15次,平均下来8分左右就有一次FullGC) - 所以这里就没有急着处理而是先保证代码上线,再次增加堆内存扛
-Xms9196m -Xmx12000m -Xmn5644m,上线之后如下FullGC情况如下
-Xms8196m -Xmx12000m -Xmn5644m- GC情况
FullGC优化
发版空闲时间看了tx-promotion-solution的jvm参数,感觉这个参数有点疑问 -XX:MaxTenuringThreshold=6,该参数指对象允许在年轻代存活年龄,这个值设置6那就意味着最多发生 ygc 6次,很多对象都会迁移到老年代?所以老年代才会那么多对象,我观察了下大概5秒一次ygc,所以一个对象只要熬过30s就会到老年代了,我感觉可以把这个参数干掉看看老年代增长趋势,可能会对减少fullgc有一定效果。
年轻代 1.8g 空闲,如果有大对象的话,年轻代也能放得下才对,应该是先填满年轻代的其他来的对象才直入老年代,我昨晚观察半个小时,年轻代一直有1.8g➕空闲。
我尝试去分析prmotion-solution的GC日志发现,触发 Full GC 不像是大对象进入老年代触发的,因为老年代增加伴随着YGC,并且交换分区使用率37%,老年代Full GC 是年轻代的对象随着年龄增加被迫进入老年代,慢慢挤满老年代空间触发的。
也确实验证了去掉对象年龄(改为默认值15)应该可以使交换分区利用率增高,减少对象进入老年代,从而减少Full GC
### 2秒间隔,观察100次
# S0: 第一个Survivor区的使用百分比%。
# S1: 第二个Survivor区的使用百分比%。
# E: Eden区的使用百分比%。
# O: 年老代的使用百分比%。
# M: 元数据区(Metaspace)的使用百分比%。
# CCS: 压缩类空间的使用百分比%。
# YGC: 年轻代垃圾回收的次数
# YGCT: 年轻代垃圾回收所花费的时间秒。
# FGC: 年老代垃圾回收的次数
# FGCT: 年老代垃圾回收所花费的时间秒。
# GCT: 总的垃圾回收时间秒(包括年轻代和年老代的回收时间)。

jstat -gcutil 1 2000 100
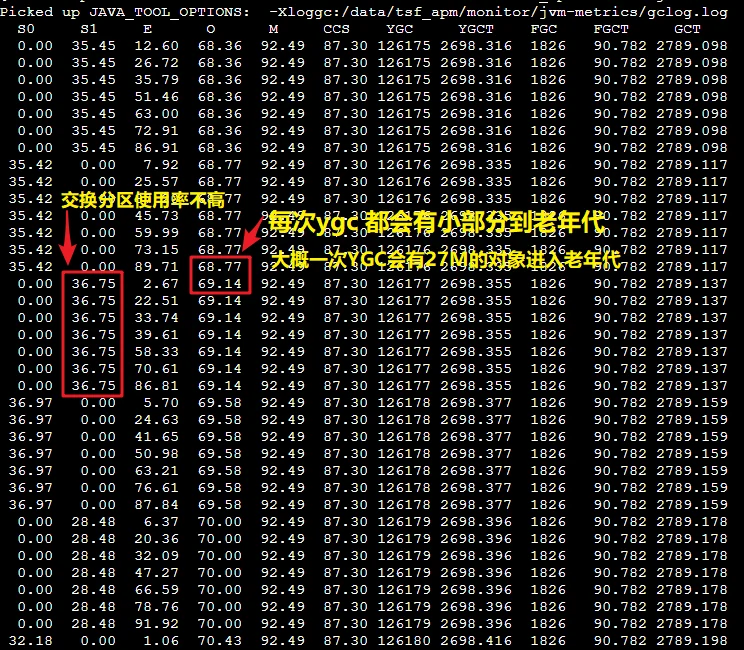
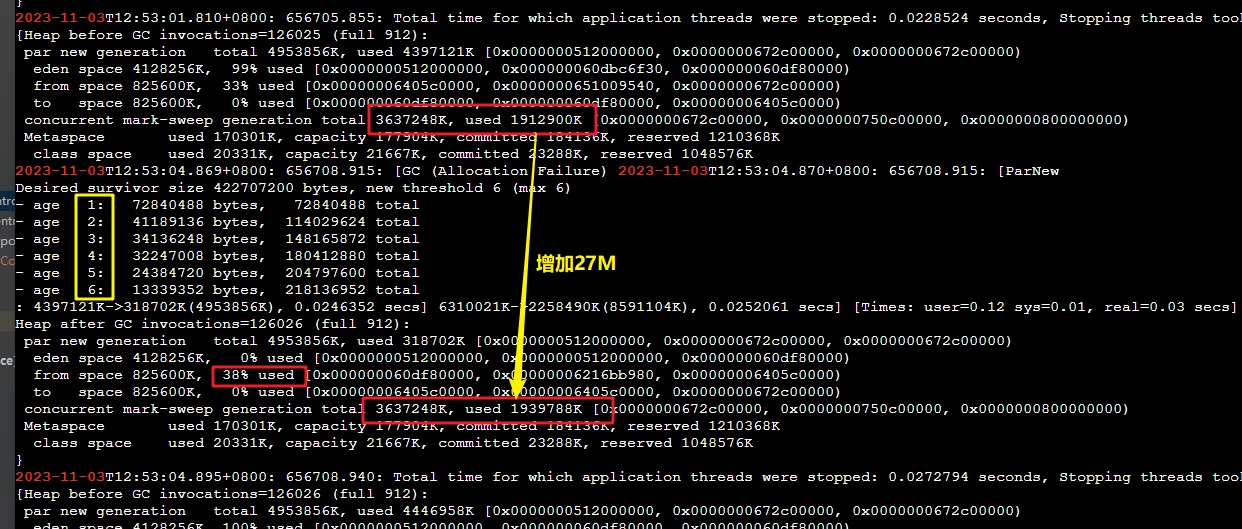
最终效果
观察发现 FullGC 由之前的每天 150 次减少至 2次.
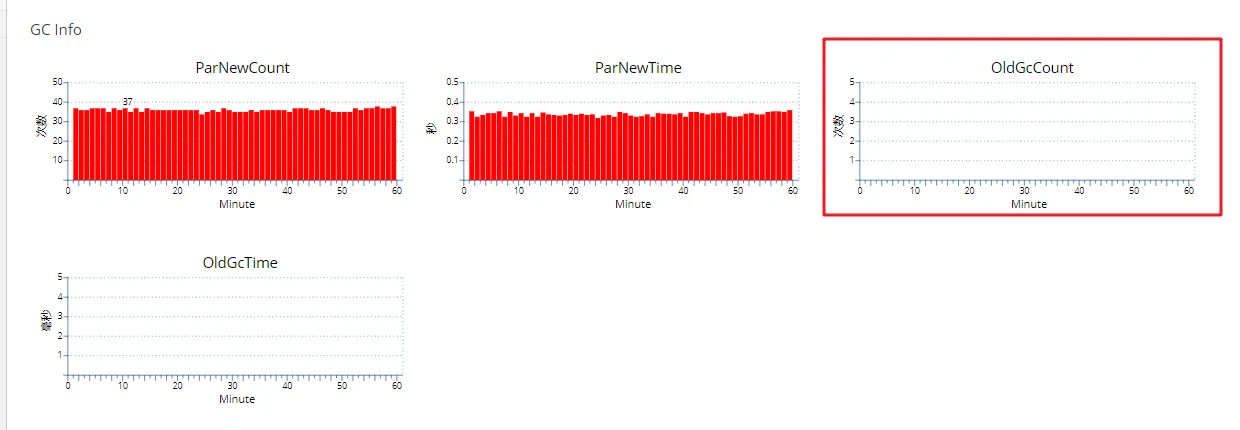
讨论